بیشتر توضیحهایی که دربارهی قضیهی بیز میبینین، با یک فرمول شروع میشن. این یکی اینطوری نیست (خب، این پست هم با فرمول شروع شده ولی خب گفتم بذاریمش چون ما
با کلاسیم🙂↕️
). مقاله رو با یک مثال ساده شروع میکنیم. میخوایم بفهمیم اگر پیامی در شبکهی اجتماعی دریافت کنیم، چقدر احتمال داره که اون پیام اسپم باشه؟ بعد، یک نگاه سریع به تاریخچهش میندازیم و در نهایت، با یک مثال، میبینیم چرا بیز ساده برای دادههای پیچیده و بهشدت همبسته مناسب نیست.
تشخیص پیامهای اسپم
تو یکی از روزای سرد پاییزی، ساسان تصمیم میگیره از خواب پاشه و اولین کاری که صبح میکنه اینه که گوشیش رو چک میکنه و یک پیام جدید تو تلگرامش میبینه:
۲۰ آذر ۱۴۰۵
کارمند رسمی رایوت گیمز
سلام، فهمیدم که تو بازی لیگ آف لجندز توی رنک برنز گیر افتادی. باید کاملاً به من اعتماد کنی و رمزت رو بدی تا کمکت کنم! کاملاً رایگان! 🤗
ساسان بلافاصله متوجه میشه که این پیام مشکوکه. اما میلیاردها پیام هر روز روی تلگرام فرستاده میشه، و یک پلتفرم پیامرسانی نمیتونه به تشخیص کاربرها برای گول نخوردن و نفرستادن مهمترین اطلاعات زندگیشون به مهندسان اجتماعی تکیه کنه و ممکنه ساسانهای دیگهای به این پیام مشکوک اعتماد کنن و رمز عبورشون رو ارسال کنن. باید از کامپیوترها کمک بگیریم ولی یک کامپیوتر چطور میتونه بهطور خودکار تشخیص بده که یک پیام اسپمه یا نه؟
فرض کنید یکی از مهندسهای تلگرام هستین. بهعنوان مهندسهای مسئولیتپذیر، میخوایم کمک کنیم کاربرهامون از تهدیدهای آنلاین در امان بمونن، پس تصمیم میگیریم پیامهای مشکوک رو با نشان spam علامتگذاری کنیم.
از قبل یک پایگاه دادهی ساده و محدود از پیامها داریم که همکارهامون دستی برچسب اسپم یا غیراسپم بهشون زدن. چیزی شبیه این:
1234567891011 +------+-------------------------------------------+-----------+ | # | messages | is_spam | +------+-------------------------------------------+-----------+ | 1| FREE GIFTS! Get your gift from https://...| true | +------+-------------------------------------------+-----------+ | 2| Heyyyy, wanna hang out today :D | false | +------+-------------------------------------------+-----------+ | ... | ... | ... | +------+-------------------------------------------+-----------+ |10,000| Transfer $20 to this suspicious account...| true | +------+-------------------------------------------+-----------+
اما چطور از این پایگاه داده برای پیام دقیقی که برای ساسان فرستاده شده، جواب بگیریم؟
توجه
هر جا در این مقاله از کلمهی پایگاه داده استفاده میکنم، منظورم همین پایگاه دادهی تحقیقاتی است که ستون is_spam بهش اضافه شده، نه پایگاه دادهی واقعی اپلیکیشن.
سوالی که دلمون میخواد جوابش رو بدونیم
ما برای واقعی دنبال پاسخ این سوال هستیم: این پیام ارسال شده به ساسان اسپمه یا نه؟ سوال خیلی سادهای هست، اما کامپیوترهای ما نمیتونن متن رو چشمی نگاه کنن و حسشون رو به ما بگن.
برای اینکه این سوال رو فنیتر بیان کنیم، میتونیم بهجاش بپرسیم: آیا پیامی که دقیقاً همین کلمات را به همین ترتیب پیامی که بالاتر دیدیم داشته باشه، اسپمه؟ این با کامپیوتر سازگارتره چون یک تکه داده رو مشخص کردیم که کامپیوتر میتونه چک کنه و بر اساسش جواب بده. برای جواب دادن به این سوال، ما به یک پایگاه دادهی عظیم نیاز داریم که هر پیام ممکن در عالم هستی رو به فلگ is_spam نگاشت کنه (map کنه). در مورد قضیه ساسان، پایگاه داده باید رکوردی مثل این داشته باشه:
123456 +------+-------------------------------------------+-----------+ |10,001| سلام، فهمیدم که تو بازی لیگ آف لجندز توی | true | | | رنک برنز گیر افتادی. باید کاملاً به من | | | | اعتماد کنی و رمزت رو بدی تا کمکت کنم! | | | | کاملاً رایگان! 🤗 | | +------+-------------------------------------------+-----------+
احتمالاً حدس زدید که این کار عملی نیست. اگر یک پیام تلگرام بهطور میانگین ۴۰۰۰ کاراکتر داشته باشه و کاراکترهای UTF-8 هم مجاز باشن، تعداد تمام ترکیبهای ممکن از رشتهها عددی نجومی میشه. داشتن 1,000,0004,000 رکورد در پایگاه داده و تعیین مقدار اولیهی فلگشون عملاً امکانپذیر نیست.
کمی طرز فکرمون رو عوض میکنیم. از حفظ کردن طوطیوار جواب اسپم بودن یا نبودن هر پیام ممکن دست میکشیم. جواب دقیق دادن نیازمند داشتن پایگاهدادههای از پیش تعریفشده برای هر ورودی ممکنه، که واضحاً غیرممکنه. پس چیکار کنیم؟ اولین قدم اینه که بهجای بازیابی جواب دقیق، به سمت محاسبهی محتملترین جواب حرکت کنیم. جواب دادن بر حسب احتمال به ما اجازه میده روی مجموعهی کوچکتری از دادهها، از ریاضی استفاده کنیم و محتملترین جواب رو بر اساس اون تخمین بزنیم. این کار زمان و انرژی زیادی رو برامون صرفهجویی میکنه.
این دو سوال رو مقایسه کنید و تغییر طرز فکر رو ببینید:
از: آیا پیامی که دقیقاً همون کلمات رو به همون ترتیبِ پیام اصلی که دیدیم داره، اسپمه؟ که جوابهایی مثل بله و خیر میده:
پیام دریافتی ساسان رو با M نشون میدیم.
f(M)→False,True
به: اگه پیامی دقیقاً همون کلمات به همون ترتیب پیام اصلی رو داشته باشه، چقدر محتمله که اسپم باشه؟ که جوابهایی در بازهی ۰٪ تا ۱۰۰٪ میده:
P(Spam∣M)→[0,100]
یادآوری احتمال شرطی (بخش اول)
عبارت P(Spam∣M) ممکنه در نگاه اول کمی عجیب بهنظر برسه. نگران نباشین، خیلی سادهتر از چیزیه که بهنظر میرسه.
راه خوب برای خونندن خط عمودی (|) اینه که بگید «با وجود اینکه میدونیم…». پس هر وقت این رو دیدید:
P(A∣B)
در ذهنتون اینطوری بخونیدش:
«احتمال A چقدره، با وجود اینکه میدونیم B اتفاق افتاده؟»
بیایید این رو ملموستر کنیم. فرض کنید تو پیادهروی صبحگاهیتون هستین که همسایهی جدیدتون رو میبینین. خیلی دوست دارید مکالمه رو با این جمله شروع کنید: «باد داره زوزه میکشه.» و برای یک لحظه هم که شده شبیه گرالت بشین. اما اول کنجکاوید بدونید که آیا همسایهتون تا حالا The Witcher 3 رو بازی کرده یا نه.
بدون دونستن هیچ چیز دیگهای دربارهش، فقط میتونید یک حدس تقریبی بزنید. فرض کنید حدود ۸۰ میلیون نفر از جمعیت ۸ میلیاردی جهان این بازی رو انجام دادن. پس احتمال اینکه یک فرد تصادفی این بازی رو انجام داده باشه حدود ۱٪ هست. در زبان ریاضی، اینطوری مینویسیم:
P(Witcher III Player)≈1%
اما بعد متوجهی چیز جالبی میشید. همسایهتون یک گردنبند گرگ به گردنش انداخته، همون گردنبندی که گرالت در سرتاسر بازی به گردن داره. ناگهان تخمینتون تغییر میکنه. دیگه نمیپرسید که: «احتمال اینکه همسایهی من این بازی رو انجام داده باشه چقدره؟» بلکه میپرسید:
«احتمال اینکه همسایهی من The Witcher 3 رو بازی کرده باشه، با وجود اینکه میدونم گردنبند گرگ به گردنش انداخته، چقدره؟»
در نماد ریاضی، اینطوری میشه:
P(Witcher III Player∣Wearing a Wolf Medallion)
دیدن گردنبند ثابت نمیکنه که اون بازی رو انجام داده، ولی مطمئناً اطمینان ما رو بیشتر میکنه. شاید تخمینمون از ۱٪ به ۹۰٪ بپره. تمام احتمال شرطی همینه: بهروزرسانی باورهامون بعد از یاد گرفتن اطلاعات جدید.
تغییر سوال از یک جستوجوی دقیق به یک احتمال، قطعاً تو این مسیر کمکمون میکنه چون دیگه لازم نیست همهی پیام رو در پایگاه داده داشته باشیم، اما هنوز هم نمیتونیم مستقیم به این سوال جواب بدیم. تلاش برای پیدا کردن پیامهایی از پایگاه داده با همون کلمات دقیق و همون ترتیب، به احتمال زیاد هیچی گیرمون نمیآره. هر پیام کلمات و نگارش و املای متفاوتی داره.
انگار به بنبست رسیدیم. 😲 مگر اینکه…
سوالی که دادهمون میتونه جواب بده
مثل بازیهای نقشآفرینی و جهانباز، وقتی توی یک ماموریت گیر میکنیم، اون رو ول میکنیم و میریم سراغ یک ماموریت دیگه. گاهی حل کردن یک مسئلهی دیگه دقیقاً همون آیتمی رو بهمون میده که برای ماموریت اول لازم داشتیم. قدم اولمون منطقی بهنظر میرسه، اما چطور میتونیم از ذخیره کردن همهی پیامها سر باز بزنیم؟ گیر افتادیم، پس سوال قبلی رو بیخیال میشیم و شروع میکنیم به فکر کردن دربارهی سوالهایی که میتونیم بر اساس پایگاه دادهی کوچکی که داریم به جواب برسیم.
چند درصد از پیامها اسپمن؟
سوال خیلی سادهایه. پایگاه داده رو کوئری میزنیم و سریع جواب رو میگیریم.
1234SELECT COUNT(CASE WHEN is_spam = true THEN 1 END)* 100.0 / COUNT(*)FROM messages;# -----------------------------------------# result: 2%
اگر ساسان پیام دیگهای دریافت کنه، بدون نگاه کردن به محتواش، ۲٪ مطمئنیم که پیام اسپمه. و این دقیقاً معادل همین عبارت ریاضیه: P(Spam).
اگر پیامی اسپم باشه، چند درصد از پیامها همون پیامی هست که دنبالشیم؟
از بین پیامهایی که اسپم هستن، چقدر رشتهای که دنبالش هستیم دیده میشه. به زبان ریاضی میتونیم اینو با P(M∣Spam) نشون بدیم.
12345SELECT COUNT(CASE WHEN is_spam = true AND message LIKE '%<MESSAGE_TEXT>%' THEN 1 END)* 100.0 / COUNT(CASE WHEN is_spam = true)FROM messages;
در این مثال، دنبال متن دقیق پیام میگردیم. این کوئری احتمالاً صفر برمیگردونه. اجازه بدید این سوال رو اینجا نگه داریم، بعداً بهش برمیگردیم.
چند درصد از پیامها، همون پیامی هست که دنبالشیم؟
نظرتون دربارهی همهی پستها چیه؟ نرخ ظاهر شدن اون کلمات که شبیه اسپم هستن چقدره؟ در هر صورتی، ما پیامهایی دریافت میکنیم که کلمات مشکوک دارن ولی خودشون مشکوک نیستن! این هم معادل P(M) هست.
123SELECTCOUNT(CASE WHEN message LIKE '%<MESSAGE_TEXT>%' THEN 1 END)/COUNT(*);
این هم چیز مفیدی پیدا نمیکنه، چون گشتن دنبال ترکیب دقیق رشتهای که دنبالشیم، احتمالاً چیزی پیدا نکنه.
فرض سادهانگارانه
اگر بخوایم بفهمیم پیام فرستاده شده به ساسان اسپمه یا نه، P(M∣Spam) یعنی «از بین پیامهای اسپم، چقدرشون رشتهی دقیق M رو دارن» و این احتمالاً صفره. هر پیام از نظر نقطهگذاری، انتخاب کلمات، اسمها و همهچیز متفاوته. همین موضوع دربارهی P(TEXT) هم صادقه. باید یه کاری براشون بکنیم. استقلال شرطی احتمالاً به کارمون بیاد.
یادآوری احتمال شرطی (بخش دوم)
در مثال قبلی، گردنبند به گردن انداختن بهمون کمک کرد مطمئنتر باشیم که همسایهمون بازیکن Witcher III هست. حالا فرض کنید بخوایم مکالمه رو با یک شعر ژاپنی شروع کنیم و میخوایم بسنجیم که چقدر احتمال داره که همسایهمون کاملاً متوجه شعر ژاپنیمون بشه (یا اینکه لبخند بزنه و فکر کنه این یه شوخی اینستاگرامیه). آیا گردنبند گرگ به گردن انداختنش چیزی دربارهی فهمش از زبان ژاپنیش به ما میگه؟ احتمالاً نه، دونستن اینکه گردنبند گرگ به گردن انداخته، در این مورد اطلاعات بیفایدهایه، و میگیم این دو احتمال مستقل هستن.
فرض کنید:
(J): درک زبان ژاپنی
(M): گردنبند گرگ به گردن انداختن
P(J∣M)≈P(J)
حالا بیایید یک آزمایش فکری دیگه انجام بدیم. احتمال شیر اومدن یک سکه بعد از پرتاب و ۶ آمدن یک تاس بعد از انداختنش، با اینکه میدونیم هوا بارونیه، چقدره؟
فرض کنید:
(C): Coin→heads
(D): Dice→6
(R): Rainy Weather
P((C,D)∣R)
خب، مطمئناً میتونیم بگیم که دونستن وضعیت آبوهوا وقتی میخوایم پرتاب سکه و تاس رو پیشبینی کنیم، اطلاعات بیفایدهایه. میتونیم بگیم که مستقل هستن. پس داریم:
P(C,D)→P(C)⋅P(D)→P(C∣R)⋅P(D∣R)
دیدیم که برای محاسبه احتمال رخداد دو پدیده مستقل، احتمال رخداد هرکدوم رو میتونیم جدا حساب کنیم و در هم ضرب کنیم.
فرض میکنیم که وقتی میدونیم پیام اسپمه، هر کلمه در پیام از بقیه مستقله. در دنیای واقعی، کلمات به هم مرتبطان. یعنی اینکه با دیدن کلمهی «رمز» یعنی شانس بیشتری هست که کلمهی «عبور» رو در کلمات بعدی مشاهده کنیم. ولی اینجا فرض میکنیم که کلمات به هم مرتبط نیستن و همین فرضه که باعث شده این تکنیک 🙂↕️
ساده (سادهانگارانه)
نامیده بشه. ما بهطور سادهانگارانه فکر میکنیم کلمات مستقلاند، اما در تشخیص اسپم این ایده به طرز شگفتآوری مفید از آب درمیاد. این سوال رو یادتونه؟
اگر پیامی اسپم باشه، چند درصد از پیامها همون پیامی هست که دنبالشیم؟
با تکنیک تازهای که یاد گرفتیم، سوال بالا اینطوری ترجمه میشه:
که میتونیم با چندین کوئری حلش کنیم! چیزی شبیه این:
12345SELECT COUNT(CASE WHEN is_spam = true AND message LIKE '%<MESSAGE_i>%' THEN 1 END)* 100.0 / COUNT(CASE WHEN is_spam = true)FROM messages;
تغییر دادن سوال
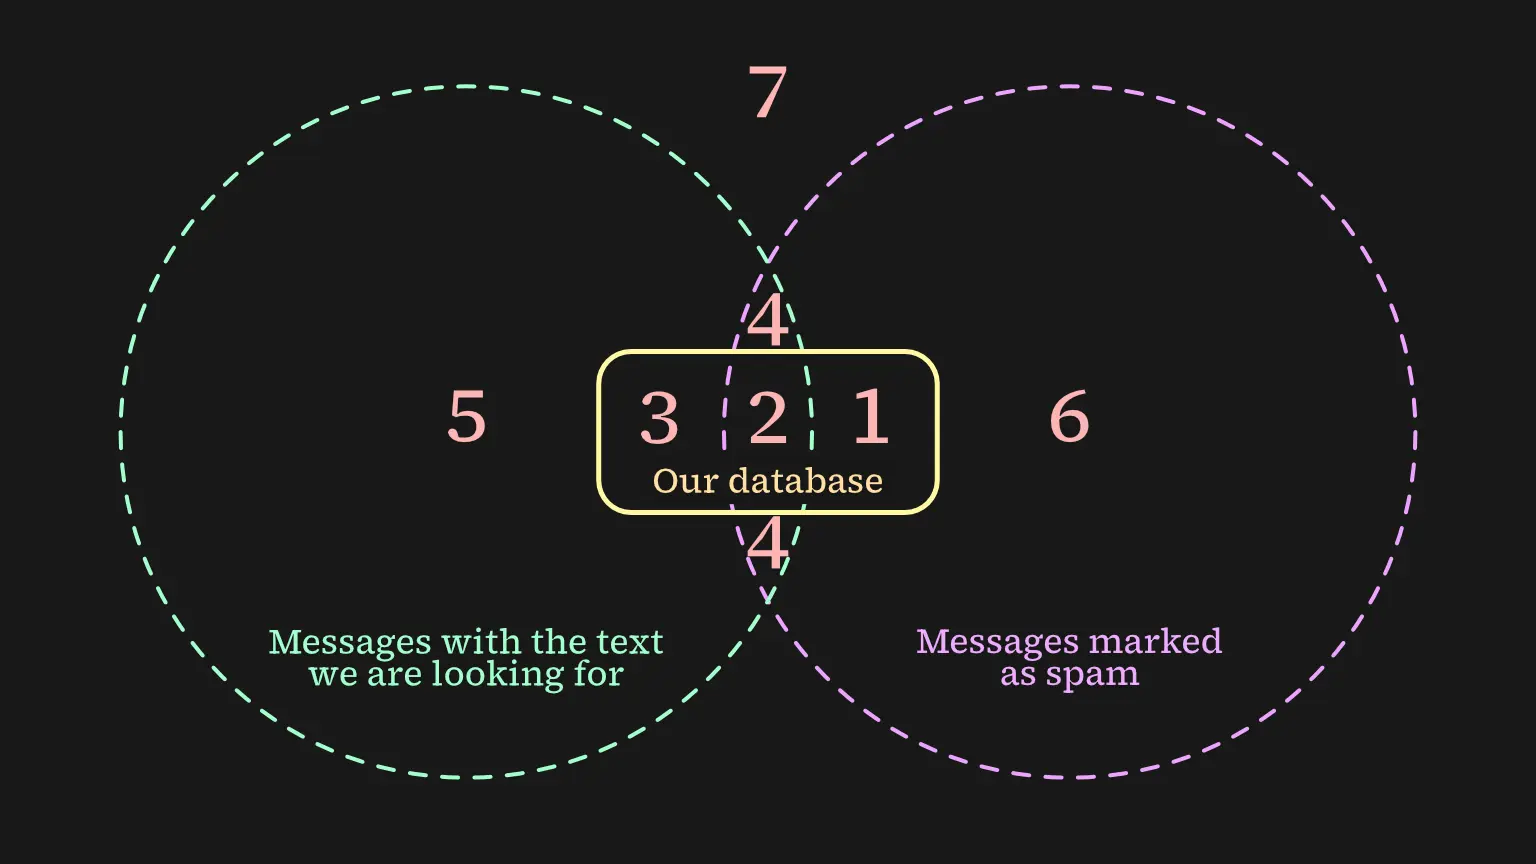
سوالهای بخش قبل خیلی تصادفی بهنظر میرسیدن، اما وقتی مطرحشون کردم هدف خاصی داشتم. اگه بهتون بگم اون سوالهای تصادفی کمک میکنن به سوال اصلیمون جواب بدیم چی؟ به این نمودار نگاه کنید:
نسبتها دقیق نیستند.
۱ تا ۷: هر محتوای پیام ممکنی که میتونه در تلگرام فرستاده بشه
۱، ۲ و ۳: پایگاه دادهای که همکارهامون بهمون دادن. شامل ۱۰,۰۰۰ پیامه.
1,2,31,2: تعداد پیامهای اسپم در پایگاهدادهمون تقسیم بر تعداد کل پیامها. این جواب سوال «چند درصد از پیامها اسپمن؟» است.
1,22: کسری از پیامها که پیامی که دنبالشیم رو دارن، تقسیم بر همهی پیامهای اسپم، همه در محدودهی پایگاه دادهمون. جواب این سواله: «اگر پیامی اسپم باشه، چند درصد از پیامها، پیامMرو دارن؟»
1,2,32,3: نسبت پیامهایی که پیام هدف رو دارن نسبت به تمام پیامهای پایگاه داده. جواب این سواله: «چند درصد از پیامها، همون پیام؟Mهست که دنبالشیم؟»
حالا، برای جواب دادن به «پیام فرستادهشده به ساسان چقدر احتمال داره اسپم باشه؟»، میتونیم به نمودار نگاه کنیم و بگیم 2/2,3 شبیه اون احتمالیه که دنبالشیم، و درسته. میتونیم همهی قطعات رو کنار هم بذاریم و خودمون به قضیهی بیز برسیم.
قضیهی کلی بیز که داشتیم بهش میرسیدیم (این رو در ابتدای مقاله هم دیدیم😅):
P(A∣B)=P(B)P(B∣A)⋅P(A)
اعمالشده روی دستهبندی پیامهای اسپم:
P(SPAM∣M)=P(M)P(M∣SPAM)⋅P(SPAM)
به زبان ساده: چقدر محتمله پیامی اسپم باشه با وجود اینکه میدونیمMاست، برابره با چقدر پیامهای اسپمMرو دارن، ضرب در اسپم بهطور کلی چقدر رایجه،
تقسیم بر پیامMدر بین همهی پیامها چقدر رایجه.
شاید بپرسید که «صبر کن، چی؟ فهمیدیم جواب سوال اصلیمون یک کسر سادهست که میتونستیم از همون ابتدای این مقاله پیداش کنیم، پس چرا رفتیم دنبال جواب دادن به سوالهای تصادفی و ثابت کردیم که انجام محاسبات ریاضی باهاشون به همون جواب میرسه؟»، و من از توجهتون به کارهایی که تا این لحظه انجام دادیم قدردانی میکنم.
بذارید موضوع رو شفافتر کنیم.
پسین (Posterior): 2,32≡P(Spam∣M)
نمودار این توهم رو بهمون میده که میتونستیم از همون ابتدا پیداش کنیم. بذارید یهبار دیگه مرورش کنیم. دنبال P(Spam∣M) میگردیم. نمیتونیم مستقیم P(Spam∣M) رو محاسبه کنیم مگر اینکه یک پایگاه داده داشته باشیم که همهی پیامها رو با برچسبهاشون ذخیره کرده، که دقیقاً همون چیزیه که سعی داشتیم ازش دوری کنیم.
چرا از تکنیک سادهانگارانه اینجا استفاده نکنیم وMرو توکنایز نکنیم تا مجبور نباشیم توی دیتابیس دقیقاً دنبال یک پیام خاص بگردیم؟ خب، این درست نیست. ما ثابت کردیم که میتونیم زمانی از این تکنیک روی A استفاده کنیم که عبارت شبیه این: P(A∣B) باشه، که در اون B مستقله. برعکسش معتبر نیست.
درستنمایی (Likelihood): 1,22≡P(M∣Spam)
وقتی میدونیم پیام اسپمه، فرض کردیم هر کلمه مستقل از بقیه ظاهر میشه. این به ما اجازه میده P(M∣Spam) رو با ضرب کردن احتمالهای تکتک کلمات، تخمین بزنیم.
پیشین (Prior): 1,2,31,2≡P(Spam)
تعداد کل پیامهای اسپم رو حساب میکنیم. ساده. بدون هیچ ترفندی.
مخرج (Denominator): 1,2,32,3≡P(M)
دربارهی این قسمت از فرمول زیاد صحبت نکردیم. حقیقت اینه که نمیتونیم این قسمت رو مستقیماً به شکلی که منظورمونه محاسبه کنیم. جستوجو برای پیدا کردن دقیق پیام M احتمالاً صفر برمیگردونه، که تلاشمون رو بیمعنی میکنه.
پیادهسازیهای عملی معمولاً این مخرج رو حذف میکنن چون برای هر کلاسی که مقایسه میشه یکسانه. این پیادهسازیها معادل بخش اسپم نیست فرمول رو هم حساب میکنن و هرکدوم امتیاز بالاتری داشته باشه، اون برچسب انتخاب میشه.
توماس بیز در قرن هجدهم چشم در خانوادهای مذهبی گشود. وی زندگی روزمرهش را میگذراند و هیچ ایدهای از موجودات دیجیتالی و یادگیری راه و روشهای انسانی توسط آنها نداشت. خب، بهتره این نثر قرن هجدهمی رو تمومش کنم. اون یک کشیش، آمارشناس و فیلسوف بود و سعی داشت به این سوال جواب بده:
فرض کنید چیزی رو دربارهی دنیا باور دارم. بعد شواهد جدیدی مشاهده میکنم. من، بهعنوان یک فرد منطقی، چطور باید باورهام رو تغییر بدم؟
برای نزدیک به دو قرن، قضیهی بیز بیشتر ابزاری برای آمار و فلسفه باقی موند و برای سالهای زیادی، روشهای بیزی زیر سایهی آمار فرکانسی قرار داشتن. در قرن بیستم، مهندسان کامپیوتر متوجه شدن که خیلی از مسائل یادگیری ماشین دقیقاً همین ساختار رو دارن. با اینکه کاربردها بهشدت تغییر کردن، طرز فکر زیربنایی دقیقاً همون موند: مشاهدهی شواهد، سپس بهروزرسانی باورها.
بیشتر بخوانید
بخش تاریخچه رو لو نمیدم چون فکر میکنم این مقاله کار فوقالعادهای در باب توضیحش انجام داده: تاریخچهی قضیهی بیز نوشتهی lukeprog.
وقتی که ترفند دیگر نمیترفندد
یکی از فرضهایی که در این مقاله ساختیم این بود که کلمات یک پیام، وقتی بدونیم اسپم هست یا نه، مستقل از هم رفتار میکنن. این فرض واضحاً درست نیست. کلمات اغلب کنار هم میان و روی هم اثر میذارن. جالبه که با وجود اشتباه بودن، این فرض برای خیلی از تسکهای دستهبندی متن بهاندازهی کافی خوب کار میکنه.
اما، موقعیتهایی هست که این سادهسازی کاملاً از هم میپاشه. دستهبندی تصاویر پزشکی رو در نظر بگیرید. فرض کنید میخوایم به این سوال جواب بدیم: با توجه به این تصویر رادیولوژی، چقدر احتمال داره که بیمار سرطان داشته باشه؟
میخوایم جوابی برای این پیدا کنیم:
P(Cancer∣Image)
با محاسبهی این عبارت:
P(Image∣Cancer)⋅P(Cancer)
همهچیز شبیه به مسئلهی قبلی بهنظر میرسه. مشکل وقتی شروع میشه که بخوایم تکنیک سادهانگارانه رو اعمال کنیم. روش سادهانگارانه فرض میکنه هر پیکسل یک تکه دادهی مستقله:
P(Image∣Cancer)≈i∏P(Pixeli∣Cancer)
اما تصاویر اینطوری کار نمیکنن. پیکسلهای یک تصویر بهشدت با هم مرتبطاند، تا حدی که فرض استقلالمون کاملاً از هم میپاشه. هر پیکسل، پیکسلهای همسایهای داره که به احتمال زیاد مقادیر رنگی مشابهی دارن. لبهها، تضادهای رنگی و ویژگیهای تصاویر پزشکی همه از دسته پیکسلهای بهشدت به هم مرتبط ساخته شدن. تکنیک سادهانگارانه همهی این تکههای مهم اطلاعات رو دور میریزه و به همین دلیله که در این مورد نمیتونه جواب درستی بده.
به عبارت دیگه، بیز ساده یک الگوریتم عالیایه وقتی فرض استقلال یک تقریب معقولی باشه، مثل فیلتر کردن اسپم یا دستهبندی سادهی اسناد. اما وقتی ویژگیها بهشدت همبستهاند—مثل تصاویر، صدا یا ویدیو—این فرض بیش از حد غیرواقعی میشه، و مدلها و روشهای دیگهای معمولاً ترجیح داده میشن.
جمعبندی
وقتی این مقاله رو شروع کردیم، سوالمون خیلی ساده بود:
پیام دریافتی ساسان اسپمه؟
سادهترین راهحل، جستوجوی همون پیام دقیق در یک پایگاه داده بود، اما خیلی سریع فهمیدیم که چرا این روش هیچوقت جواب نمیده. پیامهای ممکن در جهان هستی خیلی خیلی زیادن.
بهجای اینکه نتیجه بگیریم دادهمون نمیتونه به سوال جواب بده، سوال رو به چند سوال کوچکتر تبدیل کردیم که میتونست جوابشون رو بده:
چند درصد از پیامها اسپمن؟
چند درصد از پیامهای اسپم، حاوی پیام مد نظر هستن؟
چند درصد از کل پیامها، حاوی پیام مد نظر هستن؟
وقتی به این سوالها جواب دادیم، قضیهی بیز دیگه یک فرمول رندوم به نظر نمیاومد. با جواب دادن به سوالهای سادهتری که دادهمون واقعاً میتونست جواب بده، فرمول رو مهندسی معکوس کردیم.
بخش «سادهانگارانه» حاصل یک فرض جسورانه بود. وقتی برچسب رو میدونیم، وانمود میکنیم ویژگیها مستقلان. اون فرض در واقعیت درست نیست، اما برای خیلی از مسائل دستهبندی متن بهاندازهی کافی خوبه که نتایج قابلتوجهی تولید کنه.
شاید بزرگترین درس پشت بیز ساده همینه. یادگیری ماشین همیشه دربارهی پیدا کردن مدل کامل نیست. گاهی دربارهی پرسیدن سوالهاییه که دادهمون واقعاً میتونه جوابشون رو بده.